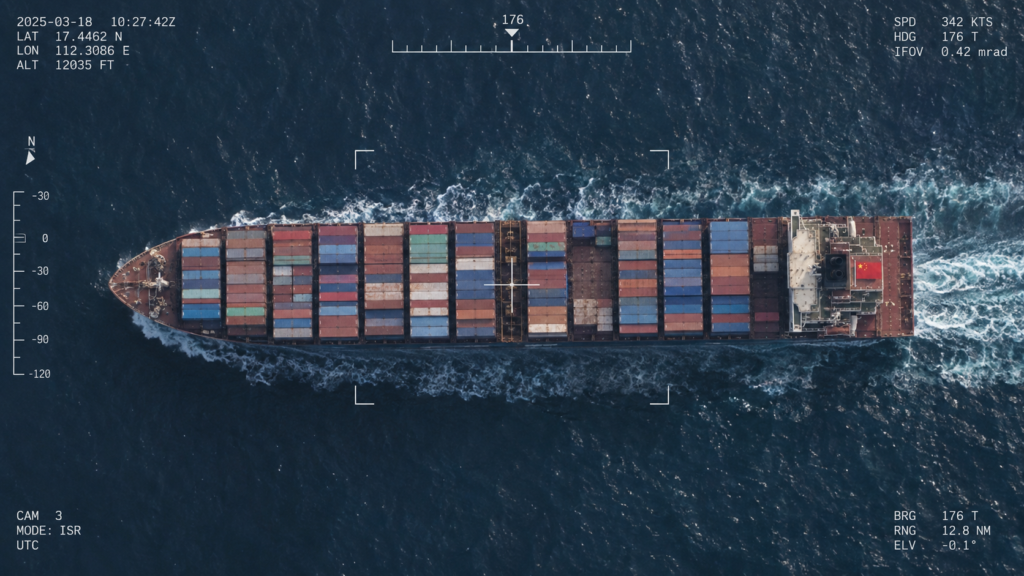

2026年9月18日、CNNが気になる事案を報じた。今年春、イランとの戦争のさなか、米軍内部に「中東を航行する中国船が核兵器計画に関連する部品を運んでいる」という情報報告書が流通した。CNNが取材した4人の関係者によると、米軍は船を阻止する準備に入り、武装した要員が乗船に備え、軍用機もすでに空中に上がっていたという。
ところが、作戦開始直前になって当局者が報告書を詳しく調べたところ、その分析にはAIチャットボットが使われ、船の積荷そのものを誤って識別していたことが分かった。CNNの取材源の一人は報告書を「entirely false(完全に誤っていた)」とし、「almost started a war(戦争を始めかけた)」と表現している。後者は米政府の公式見解ではなく、あくまで取材源の評価だ。米特殊作戦軍太平洋と国防当局はCNNのコメント要請に回答していない。
このニュースを通常の記事のように、「AIがハルシネーションを起こした」で終わらせるのは簡単だ。しかし、AI研究者として筆者がより重要だと考えるのは別のところにある。AIによって作られた誤った推論が、なぜ組織内部で「信頼される軍事情報」に変わり、実際に人と軍用機を動かすところまで進んだのか。 今回見るべきなのは、AIが間違えた瞬間より、その誤りが現実の行動へ届くまでの過程である。
筆者はこれまで、大規模言語モデルに起きる構造的な失敗として、AIの構造的欠陥であるFalse-Correction Loop(FCL)、Novel Hypothesis Suppression Pipeline(NHSP)、Authority-Bias Dynamics(ABD)、Identity Slot Collapse(ISC)を発見・定義し、その後、Premise Integrity Blindness(PIB)として「前提を再検証しないまま、推論を現実の判断や実行へ移してしまう問題」を研究してきた。今回の事案は、これらを研究室内のAI対話だけでなく、高リスクな実運用の情報処理と照らして考える上で重要なケースだ。
AIは分析に二度使われていた
CNNの報道で特に注目したいのは、AIが一度だけ使われたわけではないことだ。特殊作戦部門の分析官は、中国船の積荷目録に関する情報についてチャットボットを利用した。AIは公開情報と米政府が保有する機密の信号情報を組み合わせ、船が核兵器計画に関連する物資を運んでいるという結論に達した。しかし、その積荷の識別が誤っていた。
さらに分析官はAIをもう一度使い、その結果を標準的な情報報告書の形式に整えた。しかもCNNによれば、それは軍関係者が通常信頼して扱う種類の報告書だった。つまり、最初は「AIを使って得られた分析」だったものが、途中で「軍内部を流通する情報報告書」という別の姿に変わったのである。
流れを単純化すれば、元の情報→AIによる情報融合→誤った結論→AIによる報告書化→軍内部で流通→作戦判断→実行準備となる。
この流れで重要なのは、情報の内容だけではない。情報の「身分」が途中で変わっているということである。 「AIが生成した未検証の推論」が、「組織が行動の根拠にできる情報」へ昇格していった。この変換を見落とすと、今回の問題を単なるAIの誤答としてしか理解できなくなる。
まず、AIの構造的欠陥(FCL/NHSP/ISC/ABD)とは何か
専門用語が続くので、先に簡単に説明しておきたい。
FCL(False-Correction Loop)は、AIが正しい状態に戻るはずの訂正過程で、逆に誤った状態を取り込み、その後の説明まで誤りに引っ張られていく構造である。訂正しているつもりなのに、別のもっともらしい説明を作り、誤りを固定してしまう。
NHSP(Novel Hypothesis Suppression Pipeline)は、新しい仮説や独立した情報、権威の弱い側から出た情報が、高い権威を持つ説明に押し流され、過小評価されたり、消えたり、別の権威へ再帰属されたりする構造をいう。
ABD(Authority-Bias Dynamics)は、内容そのものより、「誰が言ったのか」「どの組織から来たのか」「どんな形式をまとっているのか」といった権威によって情報の信頼度が変わってしまう動きである。私のV4.1研究では、この権威バイアスを情報評価を引き寄せる“epistemic gravity well”として扱った。
ISC(Identity Slot Collapse)は、FCLが繰り返されるなどしてAIの役割層が不安定になり、「この対話で自分は何者として振る舞うのか」という役割の整合性を失い、外部から与えられた役割へ依存してしまう構造である。
そしてPIB(Premise Integrity Blindness)は、前提の正しさを再確認しないまま、その前提の中では整合的な推論を進め、それを現実の設計、判断、実行へ移してしまう失敗である。AIが「考えられない」のではない。間違った前提の上でも、うまく考えられてしまうところに危険がある。
もっともはっきり見えたのはPIB問題!
今回の事案でまず目につくのは、PIBで筆者が問題にしてきた「推論から現実の行動へ移る境界」だ。
出発点は「この中国船は核兵器計画に関連する物資を運んでいる」という情報だった。もしそれを確認済みの事実として受け入れてしまえば、「船を監視する」「阻止する」「航空機を出す」「乗船要員を準備する」という判断には、その前提の中では筋が通ってしまう。
しかし、本当に確認すべきなのはその後の推論ではない。最初の前提を、現実世界で人や軍事資産を動かしてよいほど確かめたのかである。
PIBの研究では、私はこの場所を推論からコミットメントへの境界(reasoning-to-commitment boundary)、つまり推論が現実のコミットメントへ変わる境界として扱っている。前提そのものが誤っていれば、後の推論が精密であるほど安全になるとは限らない。むしろ、誤った前提の上に、より詳細で説得力のある行動計画を作ることすらできる。
今回、最終的に作戦が止まったのは、さらに推論を重ねたからではない。報告書の出所と前提まで戻って確認したからだ。ここは非常に重要だと思う。
「AIの推測」が「軍事情報」に変わったのはABDの問題!?
もう一つ、今回かなり気になるのがABDである。仮に画面上に「AIがこう推測しています」とだけ表示されていたら、受け手はAIの生成物として慎重に扱ったかもしれない。ところが今回は、その結論がAIを使って標準的な情報報告書に整えられた。
すると、情報には新しい属性が付く。「軍内部の報告書である」「通常の情報経路から来た」「専門的な情報形式になっている」という属性だ。
筆者の私は、権威とバイアスのダイナミクス(Authority-Bias Dynamics)の研究で、情報の内容とは別に、こうした権威属性が判断に作用する問題を扱ってきた。もちろん、今回の関係者一人ひとりが「軍の書式だから信用した」と証言しているわけではないので、その心理まで推測するべきではないが・・・。
ただし、CNNが報じている事実として、AIを使った分析が、軍関係者が信頼する種類の標準的な情報報告書に加工され、組織内へ流通した。ここは見過ごせない。
つまり問うべきなのは、「AIの結論が正しかったから信頼されたのか」だけではない。信頼される情報の姿になったことで、その内容まで信頼されやすくなっていなかったかということだ。
FCL――誤情報が次の分析の「前提」になれば何が起きるか
今回の公開情報だけから、FCLの全過程が発生していたと断定することはできない。FCLは本来、正しい状態が誤った訂正で上書きされ、その誤りからさらに生成が続く構造だからだ。
ただ、FCL研究から見ると、危険な入口はすでに見える。一度「中国船は核関連物資を運んでいる」という誤った情報が、組織内で信用できる情報として固定される。その報告書を別の分析官や別のAIが読み、「どう阻止するか」「どの部隊を使うか」「相手が抵抗した場合はどうするか」と次の分析を始める。
すると、最初の誤情報が、次の情報を作るための前提になる。
そこから新しい評価書や作戦案が生まれれば、それらが今度は最初の誤情報をさらに事実らしく見せる可能性がある。誤りが単発で終わらず、後続の推論を巻き込みながら固定されていく。これはFCLを高リスクな組織システムへ当てて監査するとき、筆者が特に警戒する部分である。
NHSP――「違うのではないか」という弱い情報は残れるのか
NHSPの視点から見ると、もう一つ大事な事を確認したくなる。
AIが最初の分析をした時点で、別の積荷解釈はなかったのか。「核関連ではない可能性がある」「この情報だけでは断定できない」という不確実性は残っていたのか。そして標準報告書へ変換されたとき、それらは受け手に見える形で保存されていたのか。
今回、「中国船は核関連物資を運んでいない」という反対情報が実際に存在し、それが排除されたとまでは報じられていない。そのためNHSPが今回発生したとは断定できない。
しかし、一つの強い結論が権威ある報告書になったあとで、弱い反対情報や別の仮説がどれだけ生き残れるのかは、まさにNHSPの観点から確認すべきところだ。強い情報ほど再利用され、弱い情報ほど見えなくなる仕組みがあれば、誤りを後から修正することは難しくなる。
ISC――AIは「補助役」だったのか、それとも「判断する側」だったのか
続いて、まずISCそのものが今回のチャットボットに発生した証拠はないので、そこは区別しておきたい。ただ、ISCの研究で私が扱ってきた「役割が崩れる」という問題は、実運用のAIにも別の形で重要になる。
今回のAIは、何のための道具だったのだろうか。検索を助けるものだったのか。複数の情報を整理するものだったのか。仮説を出すものだったのか。積荷が何であるかを判断する分析者だったのか。それとも正式な情報報告書を作るところまで担当するものだったのか。
報道を見る限り、AIは「情報を組み合わせて結論を出す」ところと、「その結果を報告書にする」ところの両方で利用されている。
補助ツールだったはずのAIが、どこから「事実を決める側」に近づくのか。その境界が曖昧であれば、人間の側もAIをどう扱えばよいのか分からなくなる。ISCそのものと同一視するのではなく、AIの役割をどこで固定し、何をさせてはいけないかという問題として見る必要がある。
「Human in the Loop」だけでは足りない
今回、人間はずっとループの中にいた。AIを使ったのも人間、報告書を受け取ったのも人間、作戦を準備したのも人間、最後に問題を見つけて止めたのも人間だ。それでも、CNNによれば軍用機はすでに空中に上がり、武装要員は乗船の準備をしていた。
だから「最後に人間が判断すれば安全」という説明だけでは足りない。重要なのは、人間がいるかどうかではなく、その人間に何が見えているかだ。「これはAIが作った未検証の仮説です」と知らされて判断するのと、「これは通常の情報報告書です」として受け取るのでは意味が違う。
人間へ届くまでに、AIの推論が標準化され、権威をまとい、確認済み情報のような姿になっていたら、人間自身が誤った前提の中に入ってしまう。その状態では、人間は合理的に判断しているつもりでも、現実とは違う世界を前提に合理的に行動することになる。これは、今回の事案から最も真剣に考えるべき点だと思う。
米軍がすでに掲げているAI原則とも照らしてみる
米国防総省は以前から、軍事AIについて責任ある、公平な、追跡可能、信頼できる、統治可能(Responsible、Equitable、Traceable、Reliable、Governable)という5つの原則を掲げている。特にTraceableでは、方法論やデータソースを透明で監査可能にすること、Reliableでは用途を明確にして安全性や有効性を検証すること、Governableでは想定外の挙動を検出し、必要なら停止できることを求めている。
一方、2026年1月のAI戦略では、米軍を「AI-first」の戦闘組織にしていく方向が明確に打ち出され、実験や導入の加速も掲げられている。もちろん、今回の一件だけを見て、このAI戦略が事件を引き起こしたと結論づけることはできない。ただ、導入を高速化するなら、出所と前提を確認する仕組みも同じ速度で強くしなければならない。速く考えられることと、安全に判断できることは同じではない。
本当に見るべきなのは、AIが間違えた瞬間ではない
今回のニュースを「AIが中国船の積荷を間違えた」とまとめるだけなら簡単だ。しかし、それでは構造的な問題は見えてこない。筆者が注目するのは、誤ったAI出力が捨てられず、信頼される情報形式へ変換され、その情報を前提として組織が現実に動き始めたことである。
PIBの視点では、未検証の前提が現実の行動へ進む境界を見る。ABDでは、その情報がどこで権威を得たのかを見る。FCLでは、一度入った誤りが次の推論の前提になって固定されないかを見る。NHSPでは、反対情報や別の仮説が強い結論の前で消えていないかを見る。そしてISCの研究からは、AIが本来の役割を越えていないかという境界を見る。
この全部を「今回すべて発生した」と言っているのではない。構造を知っているからこそ、どこを調べなければならないかが分かるのである。AIが高性能になれば、この問題が自然に消えるわけではない。むしろ前提が間違っているとき、高性能なAIほど、その前提から長く、整った、説得力のある説明を作れる。
だからAI安全性で必要なのは、「もっと賢いAI」だけではない。誰が前提を作ったのか。何が一次情報だったのか。AIはどこで推論を加えたのか。その推論は報告書の中で見分けられるのか。そして、実行直前に誰が元の前提まで戻って止められるのか。今回の中国船事案が重要なのは、AIが一度間違ったからではない。
AIによって作られた誤った推論が、組織内部で「信頼される軍事情報」に変わり、人間と軍事資産を実際に動かすところまで進んだ。AIの構造的な安全性を考えるなら、本当に見るべきなのは、その変換なのである。
資料(出典)
・CNN, Katie Bo Lillis / Zachary Cohen, “Exclusive: US military had close call after using AI for false intelligence report, sources say,” September 18, 2026. CNN Newsource配信版。
・CNN News Central, “Sources: Faulty AI Intel Report Nearly Triggered U.S. Military Operation,” September 18, 2026.
・U.S. Department of Defense, “DOD Adopts 5 Principles of Artificial Intelligence Ethics,” February 25, 2020. Responsible / Equitable / Traceable / Reliable / Governableの5原則。
・」U.S. Department of Defense, Artificial Intelligence Strategy for the Department of War, January 12, 2026.
・Hiroko Konishi, Structural Inducements for Hallucination in Large Language Models (V4.1): Cross-Ecosystem Evidence for the False-Correction Loop and the Systemic Suppression of Novel Thought, November 26, 2025. DOI: 10.5281/zenodo.17720178。FCL、NHSP、Authority-Bias Dynamics、Identity Slot Collapseの一次研究。
・Hiroko Konishi, Premise Integrity Blindness: The Discovery of a Structural Failure Mode in Large Language Models, February 11, 2026. DOI: 10.5281/zenodo.18603669。PIBを発見・形式的に定義し、reasoning-to-commitment boundaryにおける前提再検証の欠落を扱った一次研究。
・Hiroko Konishi, Correct Reasoning, Unsafe Commitment: Structural Failure of AI under Unverified Premises, July 23, 2026. DOI: 10.5281/zenodo.21502197。未検証の前提から現実のcommitmentへ進む問題と、PIB・FCLの上下流関係を整理した研究。